
在一个包含 20,000 个运动立方体的 Unity 场景中,我们把绘制调用从 20,001 次降到了 153 次。帧时间中位数却只从 8.948 ms 降到 8.709 ms,改善了 0.24 ms。
第三种模式不再为每个立方体创建 GameObject,而是用 Graphics.RenderMeshInstanced 直接绘制,帧时间降到了 1.678 ms。比较各线程的耗时,可以解释为什么仅开启 GPU 实例化效果不大。不过,直接绘制模式的改善也不能只归因于绘制调用减少。
比较的三种绘制模式
三种模式使用同一个场景:20,000 个立方体排成圆盘,随行进的正弦波上下起伏,相机在周围缓慢旋转。每帧都会更新所有立方体的位置。同一构建类型内,三种模式使用相同的可执行文件,只通过启动参数切换。
- NAIVE:每个立方体有一个 GameObject 和一个 MeshRenderer,材质关闭 GPU 实例化
- INSTANCED_RENDERER:保留相同的 GameObject 结构,开启材质的 GPU 实例化
- INSTANCED_DIRECT:不为每个立方体单独创建 GameObject,由一个脚本通过
Graphics.RenderMeshInstanced绘制
测量配置如下:
- Unity 6000.4.11f1、Built-in Render Pipeline 前向渲染、Mono、D3D12
- RTX 4070 Ti、Core i5-13500、1920x1080 分辨率
- 所有模式均关闭 vSync 和阴影
- 关闭动态批处理和静态批处理,并确认各自的批次计数器均为 0
每种模式先预热 15 秒,再测量 120 秒。耗时取自 Release 构建,绘制计数器取自 Development 构建,以免 Development 构建的性能分析开销影响耗时比较。因此,下面两张表来自不同的运行,并不是对同一批帧的同步测量。
除非另有标注,数值均为中位数 p50。帧时间的 p95 表示 95% 的被测帧耗时不超过该值;p95 越高,分布中较慢的帧耗时越长。
在 Release 构建中使用 FrameTimingManager 测量时,请开启 Player Settings 中的 Frame Timing Stats,详见 Unity 的设置说明。数值缺失或为 0,并不代表这项工作没有开销。
帧时间与绘制计数器
| 模式 | FPS | 帧时间 | 帧时间 p95 | 游戏线程 | 渲染线程 | GPU 时间 | 内存 |
|---|---|---|---|---|---|---|---|
| NAIVE | 111.8 | 8.948 ms | 10.644 ms | 8.920 ms | 0.480 ms | 0.909 ms | 169.0 MB |
| INSTANCED_RENDERER | 114.8 | 8.709 ms | 12.919 ms | 8.680 ms | 0.519 ms | 0.703 ms | 176.6 MB |
| INSTANCED_DIRECT | 596.0 | 1.678 ms | 2.774 ms | 1.668 ms | 0.091 ms | 0.232 ms | 56.6 MB |
仅开启 GPU 实例化,帧时间中位数几乎没有变化。其他指标也没有一致改善:平均 FPS 从 111.2 降到 109.0,帧时间 p95 从 10.644 ms 升到 12.919 ms,内存从 169.0 MB 增加到 176.6 MB。不能仅凭 p50 的小幅改善,就认定性能稳定提升了。
| 模式 | 标准绘制调用 | 实例化绘制调用 | 实例批次 | SetPass Calls | 三角形 |
|---|---|---|---|---|---|
| NAIVE | 20,001 | 0 | 0 | 153 | 240,002 |
| INSTANCED_RENDERER | 1 | 152 | 149 | 153 | 240,002 |
| INSTANCED_DIRECT | 20 | 40 | 59 | 2 | 240,002 |
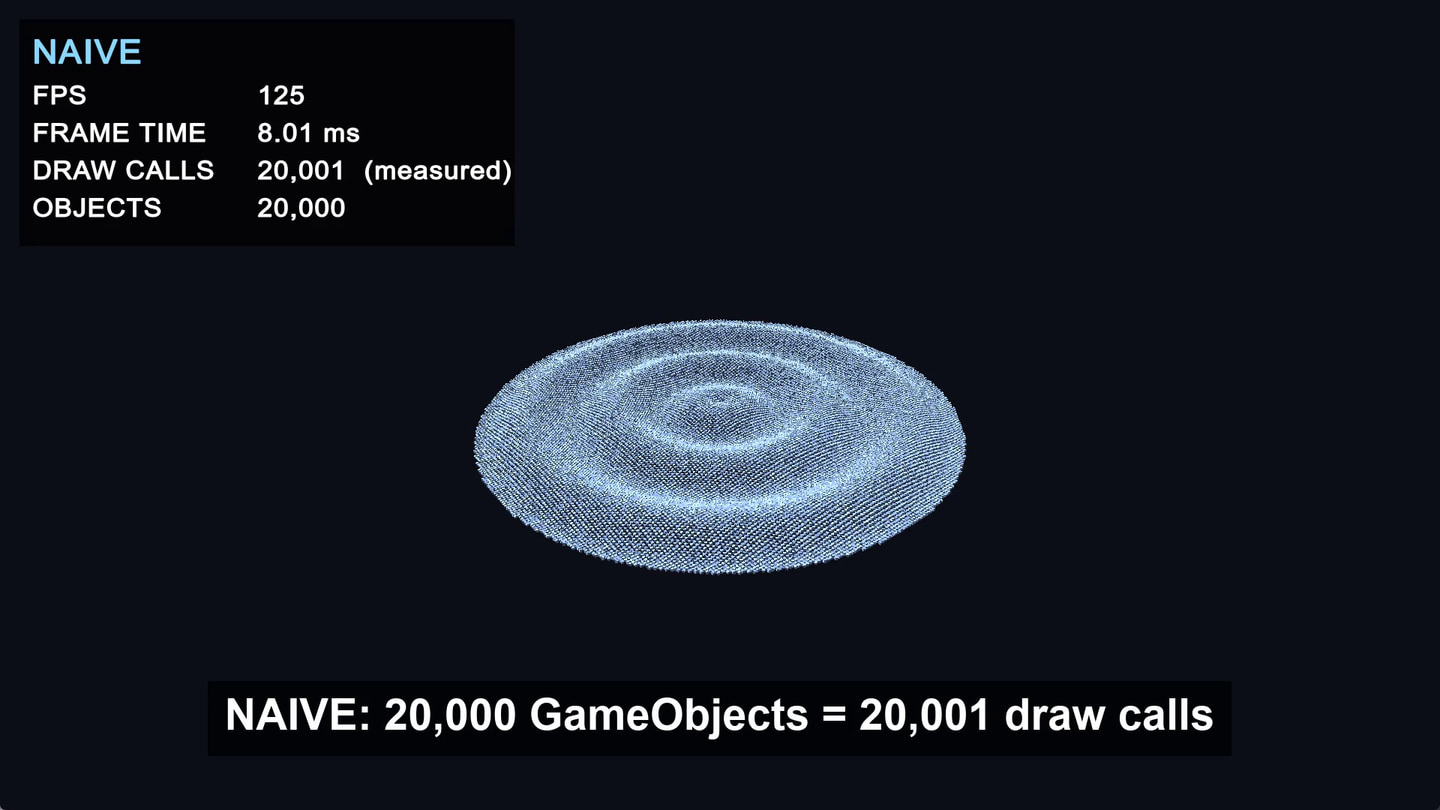
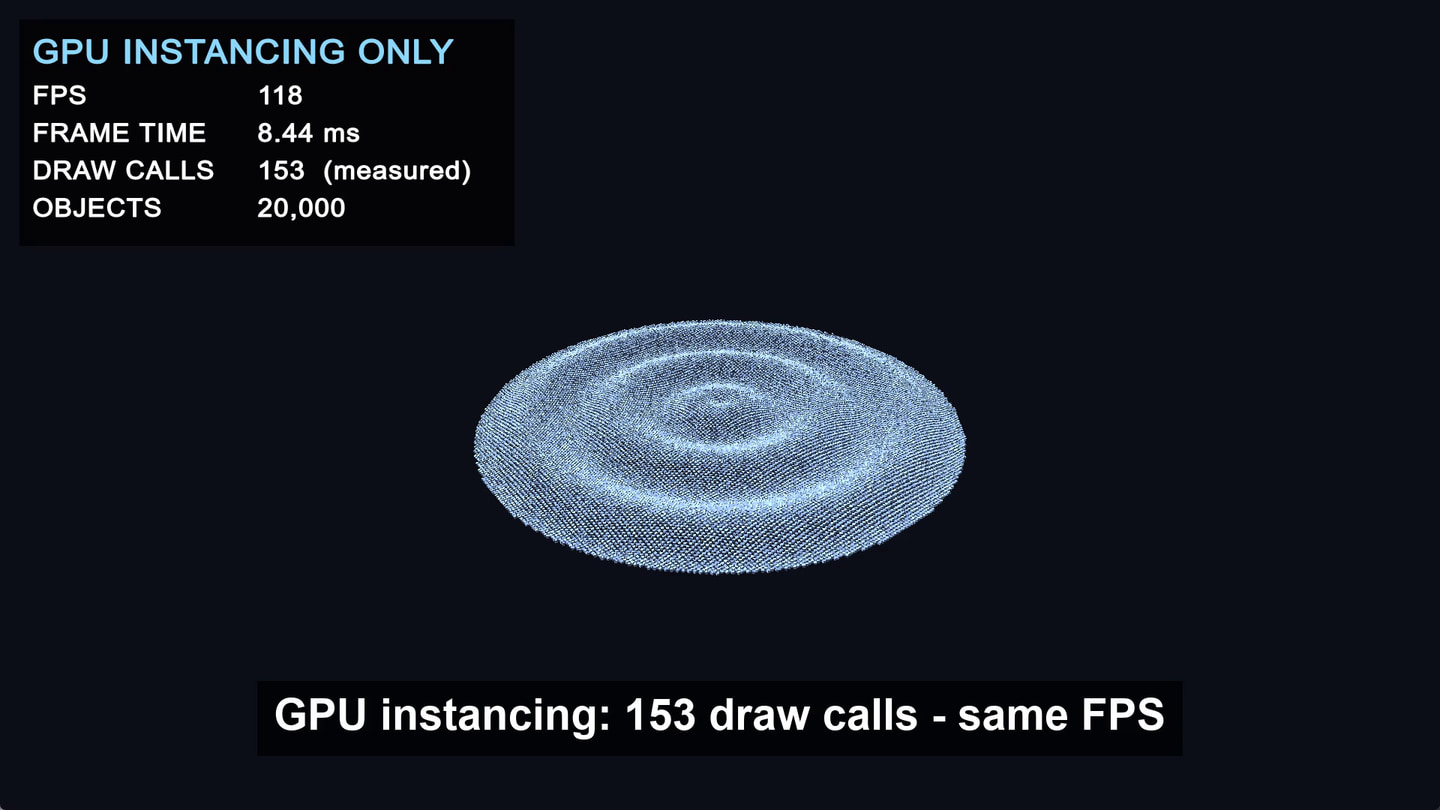
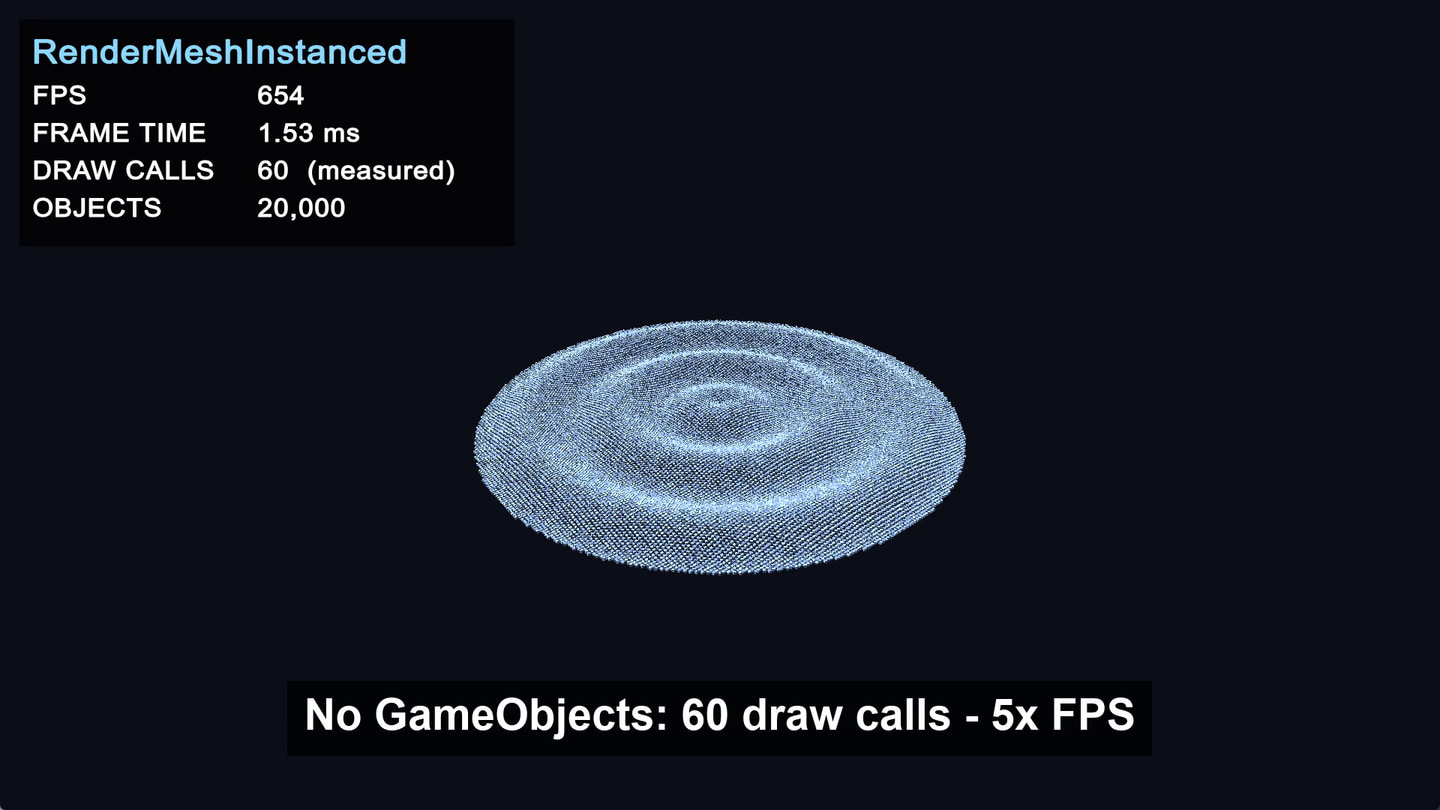
本文的“绘制调用”是标准绘制调用与实例化绘制调用之和:NAIVE 为 20,001 次,INSTANCED_RENDERER 为 1 + 152 = 153 次,INSTANCED_DIRECT 为 20 + 40 = 60 次。SetPass Calls 是另一项指标,即使数值同为 153,也不能混为一谈。NAIVE 的 20,001 次调用中,20,000 次用于立方体,剩下 1 次用于场景中的其他绘制。
下面是三种模式的截图。叠加信息显示的是截图时某一帧的值,不是表中的中位数。
如何解读各线程的耗时
NAIVE 的游戏线程耗时为 8.920 ms,几乎等于 8.948 ms 的帧时间;渲染线程为 0.480 ms,GPU 为 0.909 ms。这里的“游戏线程”指 Unity 主线程。这些时间会重叠,不能相加来计算帧时间;各指标的 p50 也不代表某一个具体帧的耗时明细。
这组比较表明,应该先检查主线程。INSTANCED_RENDERER 的结果也支持这个方向:绘制调用大幅减少后,游戏线程仍需 8.680 ms。渲染线程从 0.480 ms 变成 0.519 ms,都在 0.5 ms 左右。GPU 时间从 0.909 ms 降到 0.703 ms,却没有带来相应幅度的帧时间改善。
在自己的场景中,可以用这些时间来选择下一步检查的位置:
- 主线程时间接近帧时间:检查脚本、Transform 更新,以及主线程上的渲染准备工作
- 渲染线程时间接近帧时间:检查绘制命令提交和渲染状态切换
- GPU 时间接近帧时间:检查着色器、过度绘制和渲染通道等 GPU 工作
这些是排查方向,不是按最大值就能下的诊断。帧率限制、呈现等待和线程同步都会影响判断。时间字段的定义见 Unity 的 FrameTiming 文档,具体开销还要在 Profiler 的 Timeline 中确认。主线程耗时并不全是游戏逻辑,减少绘制调用也可能影响多个线程。
不再为每个立方体创建 GameObject 后,哪些工作变了
INSTANCED_DIRECT 不再为每个立方体创建 GameObject、Transform 和 MeshRenderer,而是由一个脚本每帧更新矩阵数组并提交绘制。这个基准测试把 20,000 个矩阵按每组 1,023 个拆分,因此每帧调用 C# API 20 次。API 调用次数与表中的绘制计数器并不一一对应。
private void RenderInstanced()
{
    for (int start = 0; start < _objectCount; start += MaxInstancesPerCall)
    {
        int chunk = Mathf.Min(MaxInstancesPerCall, _objectCount - start);
        Graphics.RenderMeshInstanced(_renderParams, _cubeMesh, 0, _matrices, chunk, start);
    }
}
1,023 是本测试使用的分组大小,不是适用于所有配置的批处理规则。Unity 给出的上限为 1,023 个实例,但实际限制取决于实例数据和着色器设置;默认的双矩阵布局允许 511 个实例。改用这段代码前,应查阅 RenderMeshInstanced API 文档。
游戏线程耗时降到了 1.668 ms,而 NAIVE 为 8.920 ms,INSTANCED_RENDERER 为 8.680 ms。这说明值得进一步检查每个立方体对应对象的维护和更新成本。组件处理、Transform 同步和剔除都是候选,但这些汇总耗时无法测出各项分别贡献了多少。
直接绘制模式同时改变了渲染路径,因此本实验不能单独算出“去掉 GameObject 节省的时间”。SetPass Calls 从 153 次降到 2 次,GPU 时间从 NAIVE 的 0.909 ms 降到 0.232 ms。结果反映的是对象表示方式与绘制方式共同变化的效果。
内存从 169.0 MB 降到 56.6 MB,减少约 112 MB。将差值除以 20,000,约为每个立方体 5.6 KB,但这不是一个 GameObject 的通用内存成本。SDK 使用的 Profiler.GetTotalAllocatedMemoryLong 返回 Unity 内部分配器正在使用的内存,不是整个进程的内存占用。
直接绘制模式仍为 20,000 个 Matrix4x4 分配了约 1.28 MB。三种模式都绘制 240,002 个三角形,因此内存下降并不需要减少画面中的几何体。不过,仅凭三角形数量相同,也无法确定究竟减少了哪些内存分配。
用 Framedash 比较运行结果
在本次实验中,Framedash 负责采集耗时并比较运行结果。Unity SDK 在 perf_heartbeat 事件中发送 frame_time_ms、game_thread_ms、render_thread_ms 和 gpu_time_ms。我们为每种模式设置不同的 BeginAutomatedSession build_id,再用 CLI 比较 NAIVE 与 INSTANCED_DIRECT。
运行前,将两个变量设置为对应的构建 ID:
framedash perf-diff --baseline "$NAIVE_BUILD_ID" --candidate "$INSTANCED_DIRECT_BUILD_ID" \
  --threshold 5 --fail-on-regression
记录的输出如下:
- 帧时间 p50:9.011 ms → 1.701 ms(-81.12%)
- GPU 时间:0.9257 ms → 0.2406 ms(-74.00%)
- 内存:175.7 MB → 59.4 MB(-66.20%)
- 每种模式 133 个样本,判定为“No performance regression beyond 5%”
这些数值与表格不同,因为聚合的样本不同。预热后的 120 秒自动会话中,服务端合并了每秒发送的事件和每 10 秒发送的 perf_heartbeat,每种模式共 133 个样本。表格使用的则是逐帧样本。上面的数值精度保留了当时的服务端输出。
发布前也可以从 CI 执行这个比较,但抽样数据的 p50 不能代替逐帧的尾部延迟分析。判定只针对所比较的指标和阈值,不会确定瓶颈,也不代表每一帧都变快了。
这个实验能说明什么
这是在一种软硬件配置上运行的一种工作负载,而且每个立方体每帧都在移动。它说明:在本测试中,仅开启 GPU 实例化对帧时间中位数帮助很小,而直接绘制模式显著更快。它不能预测大部分对象静止,或渲染成本不同的场景能改善多少。
移动设备、其他图形 API、使用 SRP Batcher 的 URP 或 HDRP、IL2CPP,以及阴影,都可能改变耗时比例。绘制计数器的逐帧波动也很大,因此这里报告中位数,不依赖最小值或最大值。现有结果没有给出重复运行之间的波动范围;在把 0.24 ms 这样的微小差异视为稳定收益前,应先重复测量基线。
减少绘制调用之前,先做三项检查
- 在有代表性的构建中采集有效的主线程、渲染线程和 GPU 耗时,并检查帧率限制与等待时间
- 在 Profiler 中定位耗时较高的工作。主线程耗时高,意味着该检查对象更新,并不意味着应该直接删除 GameObject
- 尽量一次只改变一个可能的原因,重复相同工作负载,比较帧时间中位数、较慢的帧和内存
- 指标定义:数据模型
- SDK 接入步骤:Unity SDK 指南