
큐브 20,000개가 움직이는 Unity 씬에서 드로우 콜을 20,001회에서 153회로 줄였습니다. 프레임 타임 중앙값은 8.948 ms에서 8.709 ms로, 0.24 ms 줄어드는 데 그쳤습니다.
반면 큐브별 GameObject를 없애고 Graphics.RenderMeshInstanced로 직접 그리는 세 번째 모드에서는 1.678 ms를 기록했습니다. 스레드별 시간을 비교하면 GPU 인스턴싱만 켰을 때 효과가 작았던 이유를 알 수 있습니다. 다만 직접 그리는 모드의 개선 폭도 드로우 콜 감소만으로 설명할 수는 없습니다.
비교한 세 가지 렌더링 모드
세 모드 모두 같은 씬을 사용합니다. 원반 모양으로 배치한 큐브 20,000개가 진행하는 사인파에 따라 움직이고, 카메라는 그 주위를 천천히 돕니다. 매 프레임 모든 큐브의 위치를 갱신합니다. 같은 빌드 유형 안에서는 실행 파일도 같으며, 시작 인자로 모드만 바꿉니다.
- NAIVE: 큐브마다 GameObject와 MeshRenderer를 하나씩 두고, 머티리얼의 GPU 인스턴싱은 비활성화
- INSTANCED_RENDERER: 같은 GameObject 구성을 유지하고 머티리얼의 GPU 인스턴싱을 활성화
- INSTANCED_DIRECT: 큐브별 GameObject 없이 스크립트 하나에서
Graphics.RenderMeshInstanced로 렌더링
측정 환경은 다음과 같습니다.
- Unity 6000.4.11f1, Built-in Render Pipeline의 포워드 렌더링, Mono, D3D12
- RTX 4070 Ti, Core i5-13500, 해상도 1920x1080
- 모든 모드에서 vSync와 그림자 비활성화
- 동적 배칭과 정적 배칭을 비활성화하고 각각의 배치 카운터가 0인지 확인
각 모드를 15초 동안 워밍업한 뒤 120초 동안 측정했습니다. 시간은 Release 빌드에서, 렌더링 카운터는 Development 빌드에서 수집했습니다. Development 빌드의 프로파일링 오버헤드가 시간 비교에 섞이지 않도록 한 것입니다. 따라서 아래 두 표는 별도 실행 결과이며, 같은 프레임을 동시에 측정한 값이 아닙니다.
따로 표시하지 않은 값은 중앙값인 p50입니다. 프레임 타임 p95는 측정한 프레임의 95%가 그 값 이하의 시간이 걸렸다는 뜻입니다. p95가 높을수록 분포에서 느린 쪽에 속하는 프레임의 시간이 길어집니다.
Release 빌드에서 FrameTimingManager로 측정하려면 Player Settings의 Frame Timing Stats를 켭니다. Unity의 설정 안내를 참고하세요. 값이 없거나 0이라고 해서 해당 작업에 비용이 없다는 뜻은 아닙니다.
프레임 타임과 렌더링 카운터
| 모드 | FPS | 프레임 타임 | 프레임 타임 p95 | 게임 스레드 | 렌더 스레드 | GPU 시간 | 메모리 |
|---|---|---|---|---|---|---|---|
| NAIVE | 111.8 | 8.948 ms | 10.644 ms | 8.920 ms | 0.480 ms | 0.909 ms | 169.0 MB |
| INSTANCED_RENDERER | 114.8 | 8.709 ms | 12.919 ms | 8.680 ms | 0.519 ms | 0.703 ms | 176.6 MB |
| INSTANCED_DIRECT | 596.0 | 1.678 ms | 2.774 ms | 1.668 ms | 0.091 ms | 0.232 ms | 56.6 MB |
GPU 인스턴싱만 켜서는 중앙값이 거의 달라지지 않았습니다. 다른 지표도 일관되게 좋아지지는 않았습니다. 평균 FPS는 111.2에서 109.0으로 떨어졌고, 프레임 타임 p95는 10.644 ms에서 12.919 ms로, 메모리는 169.0 MB에서 176.6 MB로 늘었습니다. p50이 조금 개선됐다는 이유만으로 안정적인 성능 향상이라고 판단할 수는 없습니다.
| 모드 | 표준 드로우 콜 | 인스턴스화 드로우 콜 | 인스턴스 배치 | SetPass Calls | 삼각형 |
|---|---|---|---|---|---|
| NAIVE | 20,001 | 0 | 0 | 153 | 240,002 |
| INSTANCED_RENDERER | 1 | 152 | 149 | 153 | 240,002 |
| INSTANCED_DIRECT | 20 | 40 | 59 | 2 | 240,002 |
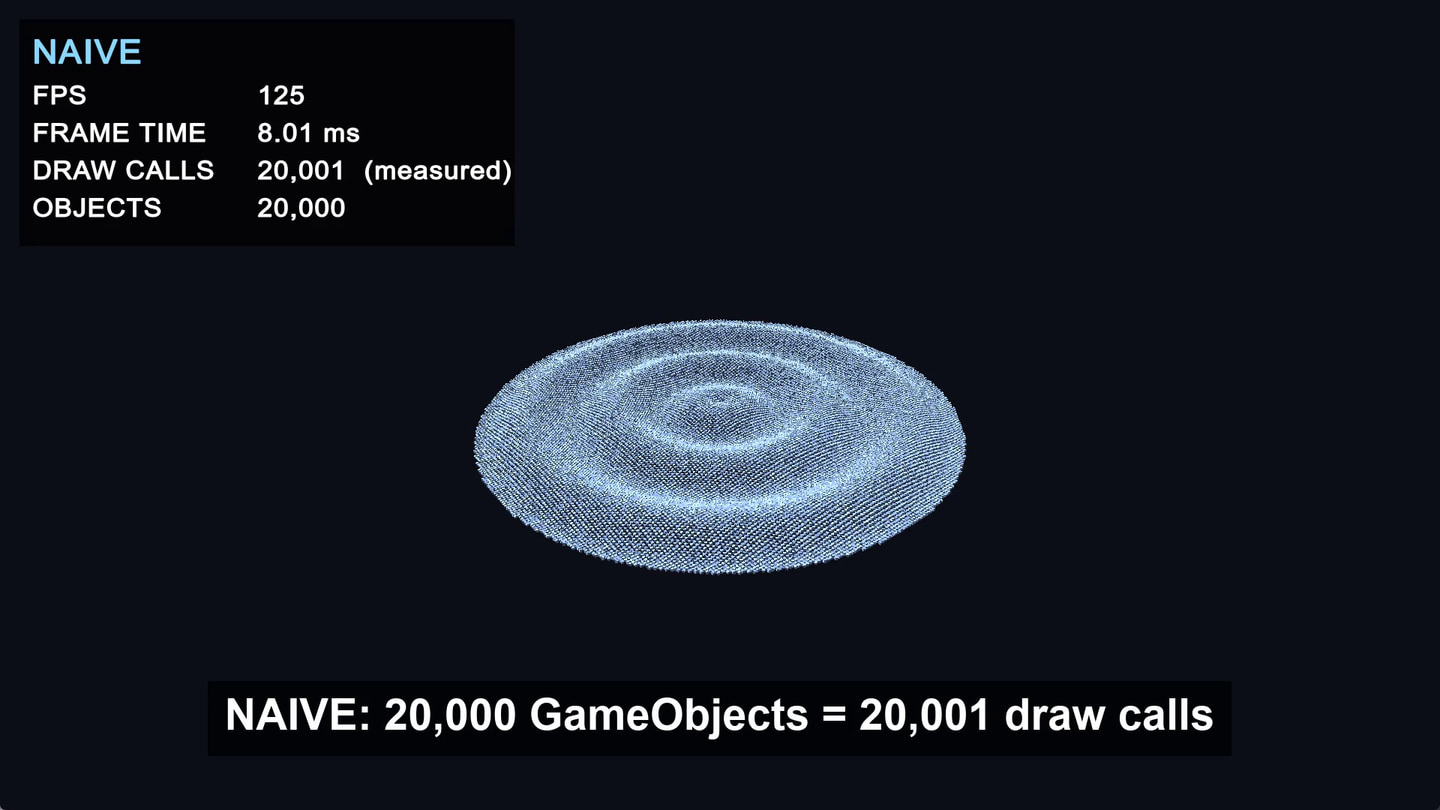
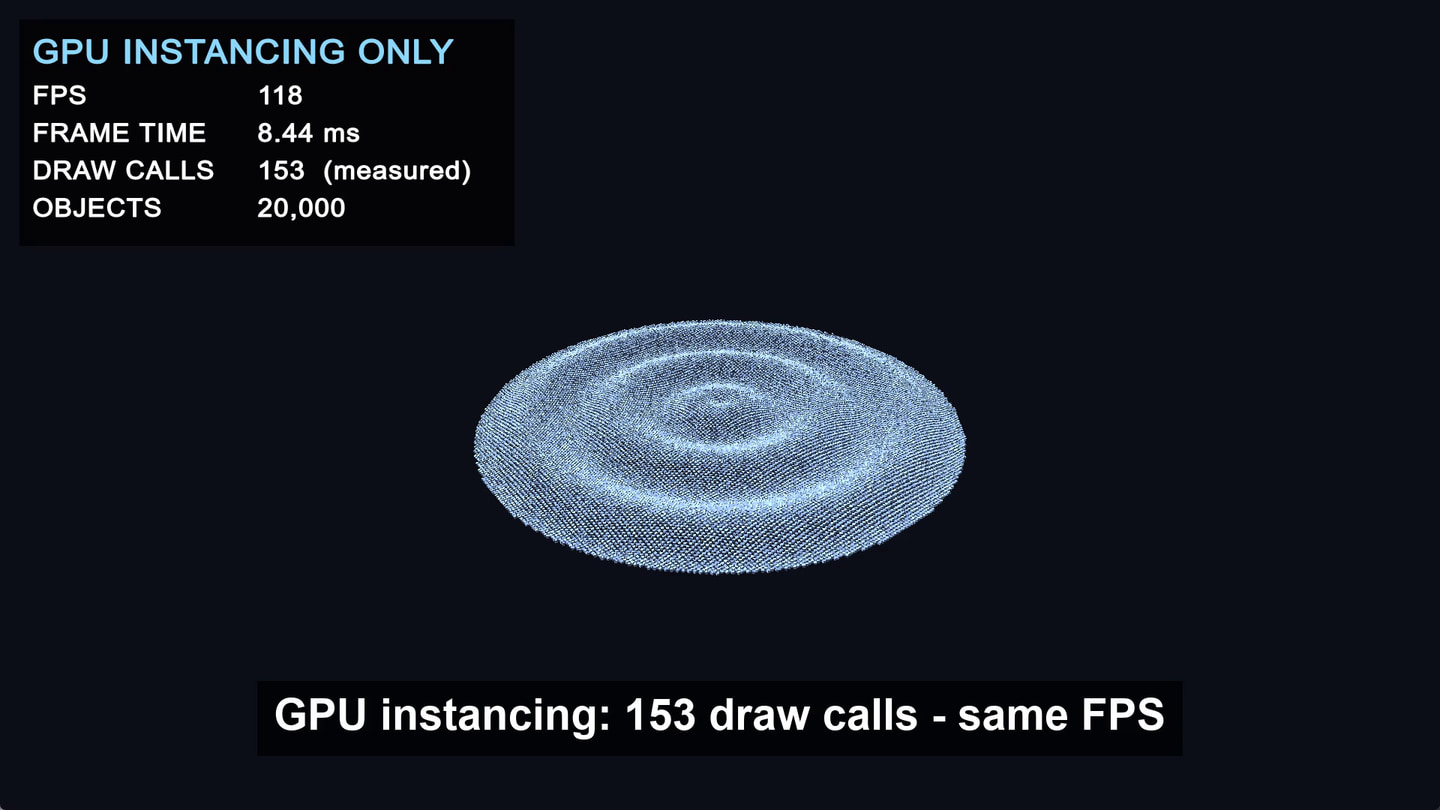
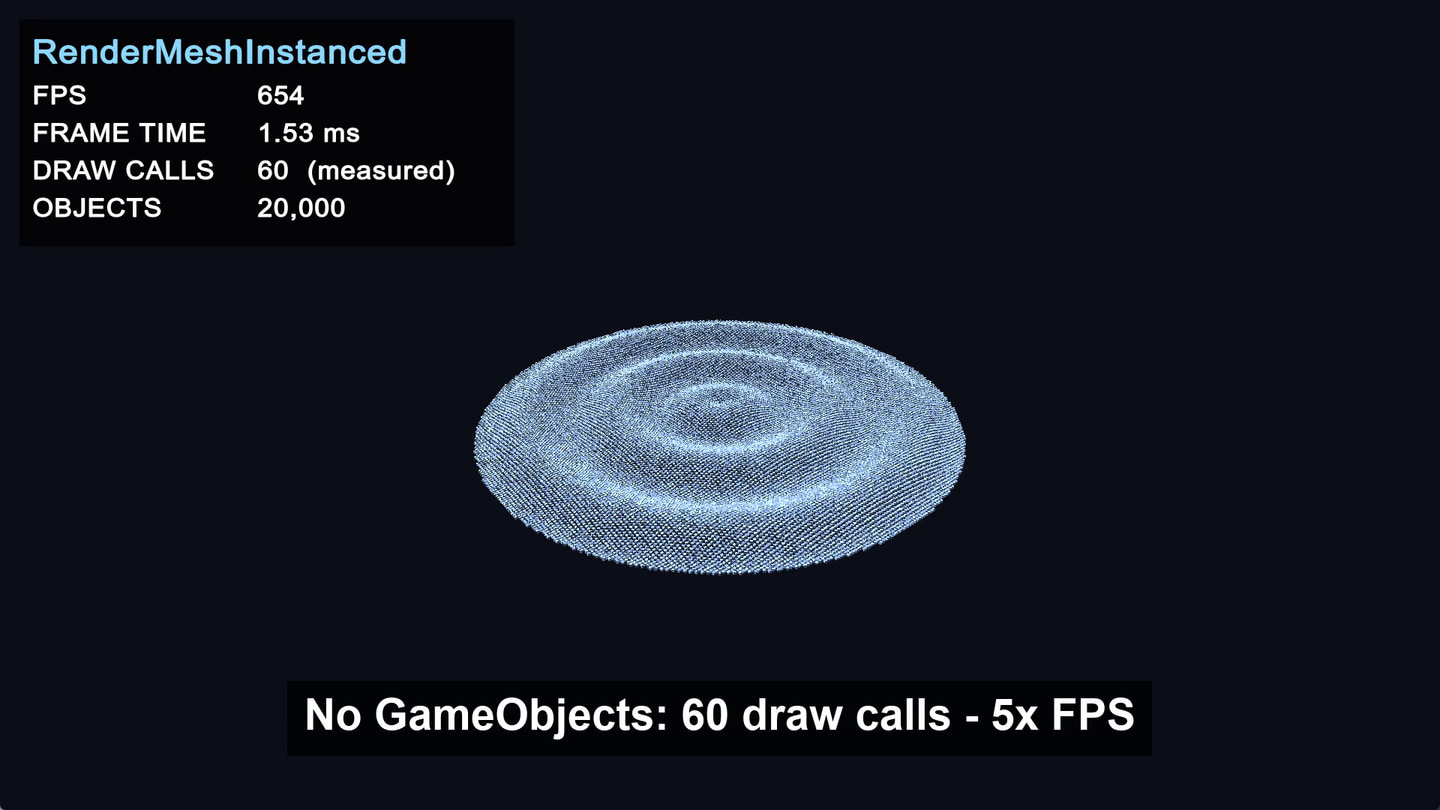
이 글의 드로우 콜은 표준 드로우 콜과 인스턴스화 드로우 콜의 합계입니다. NAIVE는 20,001회, INSTANCED_RENDERER는 1 + 152 = 153회, INSTANCED_DIRECT는 20 + 40 = 60회입니다. SetPass Calls에도 153이라는 값이 있지만 서로 다른 지표입니다. NAIVE의 20,001회 중 20,000회는 큐브를, 나머지 1회는 씬의 다른 부분을 그립니다.
아래는 세 모드의 화면입니다. 오버레이는 캡처한 순간의 한 프레임 값을 보여 주므로, 표의 중앙값과는 다릅니다.
스레드별 시간에서 알 수 있는 것
NAIVE의 게임 스레드 시간은 8.920 ms로, 프레임 타임 8.948 ms와 거의 같았습니다. 렌더 스레드는 0.480 ms, GPU는 0.909 ms였습니다. 여기서 게임 스레드는 Unity의 메인 스레드를 가리킵니다. 이 시간들은 서로 겹치므로 더해서 프레임 타임을 구할 수 없습니다. 지표별 p50을 나란히 놓아도 특정한 한 프레임의 내역이 되지는 않습니다.
이 비교에서는 메인 스레드부터 살펴보는 것이 타당합니다. INSTANCED_RENDERER의 결과도 이를 뒷받침합니다. 드로우 콜이 크게 줄었는데도 게임 스레드는 여전히 8.680 ms였습니다. 렌더 스레드는 0.480 ms에서 0.519 ms로, 둘 다 약 0.5 ms였습니다. GPU 시간은 0.909 ms에서 0.703 ms로 줄었지만 프레임 타임이 그만큼 줄지는 않았습니다.
자신의 씬에서는 다음 조사 대상을 고르는 기준으로 활용할 수 있습니다.
- 메인 스레드 시간이 프레임 타임에 가까움: 스크립트, Transform 갱신, 메인 스레드의 렌더링 준비 작업 확인
- 렌더 스레드 시간이 프레임 타임에 가까움: 렌더링 명령 제출과 렌더 상태 전환 확인
- GPU 시간이 프레임 타임에 가까움: 셰이더, 오버드로우, 렌더 패스 등 GPU 작업 확인
이는 조사 방향이지, 가장 큰 숫자만으로 내리는 진단은 아닙니다. 프레임 제한, 화면 표시 대기, 스레드 간 동기화도 영향을 줍니다. 시간 필드의 정의는 Unity의 FrameTiming 문서에서 확인하고, 세부 비용은 Profiler의 Timeline에서 추적해야 합니다. 메인 스레드 시간이 모두 게임 로직은 아니며, 드로우 콜 감소가 여러 스레드에 영향을 줄 수도 있습니다.
큐브별 GameObject를 없애며 달라진 작업
INSTANCED_DIRECT는 큐브마다 GameObject, Transform, MeshRenderer를 만들지 않습니다. 스크립트 하나에서 매 프레임 행렬 배열을 갱신하고 렌더링을 요청합니다. 이 벤치마크는 행렬 20,000개를 1,023개씩 나눠 전달하므로 C# API를 20회 호출합니다. API 호출 횟수와 표의 렌더링 카운터는 일대일로 대응하지 않습니다.
private void RenderInstanced()
{
    for (int start = 0; start < _objectCount; start += MaxInstancesPerCall)
    {
        int chunk = Mathf.Min(MaxInstancesPerCall, _objectCount - start);
        Graphics.RenderMeshInstanced(_renderParams, _cubeMesh, 0, _matrices, chunk, start);
    }
}
1,023은 이 벤치마크가 사용하는 묶음 크기이며 모든 구성에 적용되는 배칭 규칙은 아닙니다. Unity가 명시한 상한은 인스턴스 1,023개이지만, 실제 한도는 인스턴스 데이터와 셰이더 설정에 따라 달라집니다. 행렬 두 개를 사용하는 기본 구성에서는 511개입니다. 코드를 적용할 때는 RenderMeshInstanced API 문서를 확인해야 합니다.
게임 스레드 시간은 1.668 ms로 줄었습니다. NAIVE의 8.920 ms, INSTANCED_RENDERER의 8.680 ms와 비교하면 큐브별 오브젝트의 유지 및 갱신 비용을 살펴볼 근거가 됩니다. 컴포넌트 처리, Transform 동기화, 컬링 등이 후보지만, 이 집계값으로 각 작업의 기여도를 따로 측정할 수는 없습니다.
직접 렌더링 모드는 렌더링 경로도 바꾸므로, 이 실험만으로 GameObject 제거만의 절감 효과를 분리할 수 없습니다. SetPass Calls는 153회에서 2회로, GPU 시간은 NAIVE의 0.909 ms에서 0.232 ms로 줄었습니다. 이는 오브젝트 표현 방식과 렌더링 방식을 함께 바꾼 결과입니다.
메모리는 169.0 MB에서 56.6 MB로 약 112 MB 줄었습니다. 차이를 20,000으로 나누면 큐브당 약 5.6 KB이지만, GameObject 하나의 일반적인 메모리 비용을 뜻하지는 않습니다. SDK가 사용하는 Profiler.GetTotalAllocatedMemoryLong은 Unity 내부 할당자가 사용 중인 메모리를 반환하며, 프로세스 전체 메모리 사용량과는 범위가 다릅니다.
직접 렌더링 모드도 Matrix4x4 20,000개에 약 1.28 MB를 할당합니다. 세 모드 모두 삼각형 240,002개를 그렸으므로 화면의 지오메트리를 줄이지 않고 메모리를 절약한 것입니다. 다만 삼각형 수가 같다는 사실만으로 어떤 메모리 할당이 사라졌는지 알 수는 없습니다.
Framedash로 실행 결과 비교하기
이번 실험에서 Framedash는 시간을 수집하고 실행 결과를 비교하는 데 사용했습니다. Unity SDK는 perf_heartbeat 이벤트에 frame_time_ms, game_thread_ms, render_thread_ms, gpu_time_ms를 담아 전송합니다. 모드마다 BeginAutomatedSession의 build_id를 다르게 지정한 뒤, CLI로 NAIVE와 INSTANCED_DIRECT를 비교했습니다.
두 변수에 해당 빌드 ID를 설정한 뒤 실행합니다.
framedash perf-diff --baseline "$NAIVE_BUILD_ID" --candidate "$INSTANCED_DIRECT_BUILD_ID" \
  --threshold 5 --fail-on-regression
기록한 출력은 다음과 같습니다.
- 프레임 타임 p50: 9.011 ms → 1.701 ms(-81.12%)
- GPU 시간: 0.9257 ms → 0.2406 ms(-74.00%)
- 메모리: 175.7 MB → 59.4 MB(-66.20%)
- 모드별 133개 샘플, 판정: “No performance regression beyond 5%”
표와 값이 다른 이유는 집계한 샘플이 다르기 때문입니다. 서버는 워밍업 후 120초 자동 세션 동안 1초마다 보낸 이벤트와 10초마다 보낸 perf_heartbeat를 합쳐 모드별 133개 샘플을 집계했습니다. 반면 표는 프레임별 샘플을 사용합니다. 위 수치의 소수 자릿수는 당시 서버 출력 그대로입니다.
이 비교를 릴리스 전에 CI에서 실행할 수도 있지만, 간격을 두고 수집한 샘플의 p50으로 느린 프레임의 개별 분석을 대신할 수는 없습니다. 판정은 비교 대상 지표와 임계값에 대한 결과이며, 병목을 찾아 주거나 모든 프레임이 빨라졌음을 입증하지는 않습니다.
이 실험이 보여 주는 범위
이번 결과는 하나의 하드웨어 및 소프트웨어 구성에서 모든 큐브를 매 프레임 움직인 워크로드에 해당합니다. 이 테스트에서는 GPU 인스턴싱만으로 얻은 프레임 타임 중앙값의 개선이 작았고, 직접 렌더링 모드는 크게 빨라졌습니다. 대부분의 오브젝트가 정지해 있거나 렌더링 비용이 다른 씬에서 기대할 개선 폭을 보여 주지는 않습니다.
모바일 기기, 다른 그래픽스 API, SRP Batcher를 사용하는 URP나 HDRP, IL2CPP, 그림자 설정에 따라 작업 비중은 달라질 수 있습니다. 렌더링 카운터도 프레임별 편차가 커서 최솟값이나 최댓값에 의존하지 않고 중앙값을 실었습니다. 이 결과만으로 반복 실행 사이의 편차는 알 수 없습니다. 0.24 ms처럼 작은 차이를 안정적인 개선으로 판단하기 전에 베이스라인을 반복 측정해야 합니다.
드로우 콜을 줄이기 전에 확인할 것
- 실제 사용 조건에 가까운 빌드에서 유효한 메인 스레드, 렌더 스레드, GPU 시간을 수집하고 프레임 제한과 대기 시간을 확인합니다
- Profiler에서 비용이 큰 작업을 찾습니다. 메인 스레드 시간이 길면 오브젝트 갱신을 조사할 이유가 되지만, 그것만으로 GameObject를 없앨 근거가 되지는 않습니다
- 가능하면 의심되는 요인 하나만 바꾸고 같은 워크로드를 반복해 중앙값, 느린 프레임, 메모리를 비교합니다
- 지표 정의: 데이터 모델
- SDK 설정: Unity SDK 가이드